

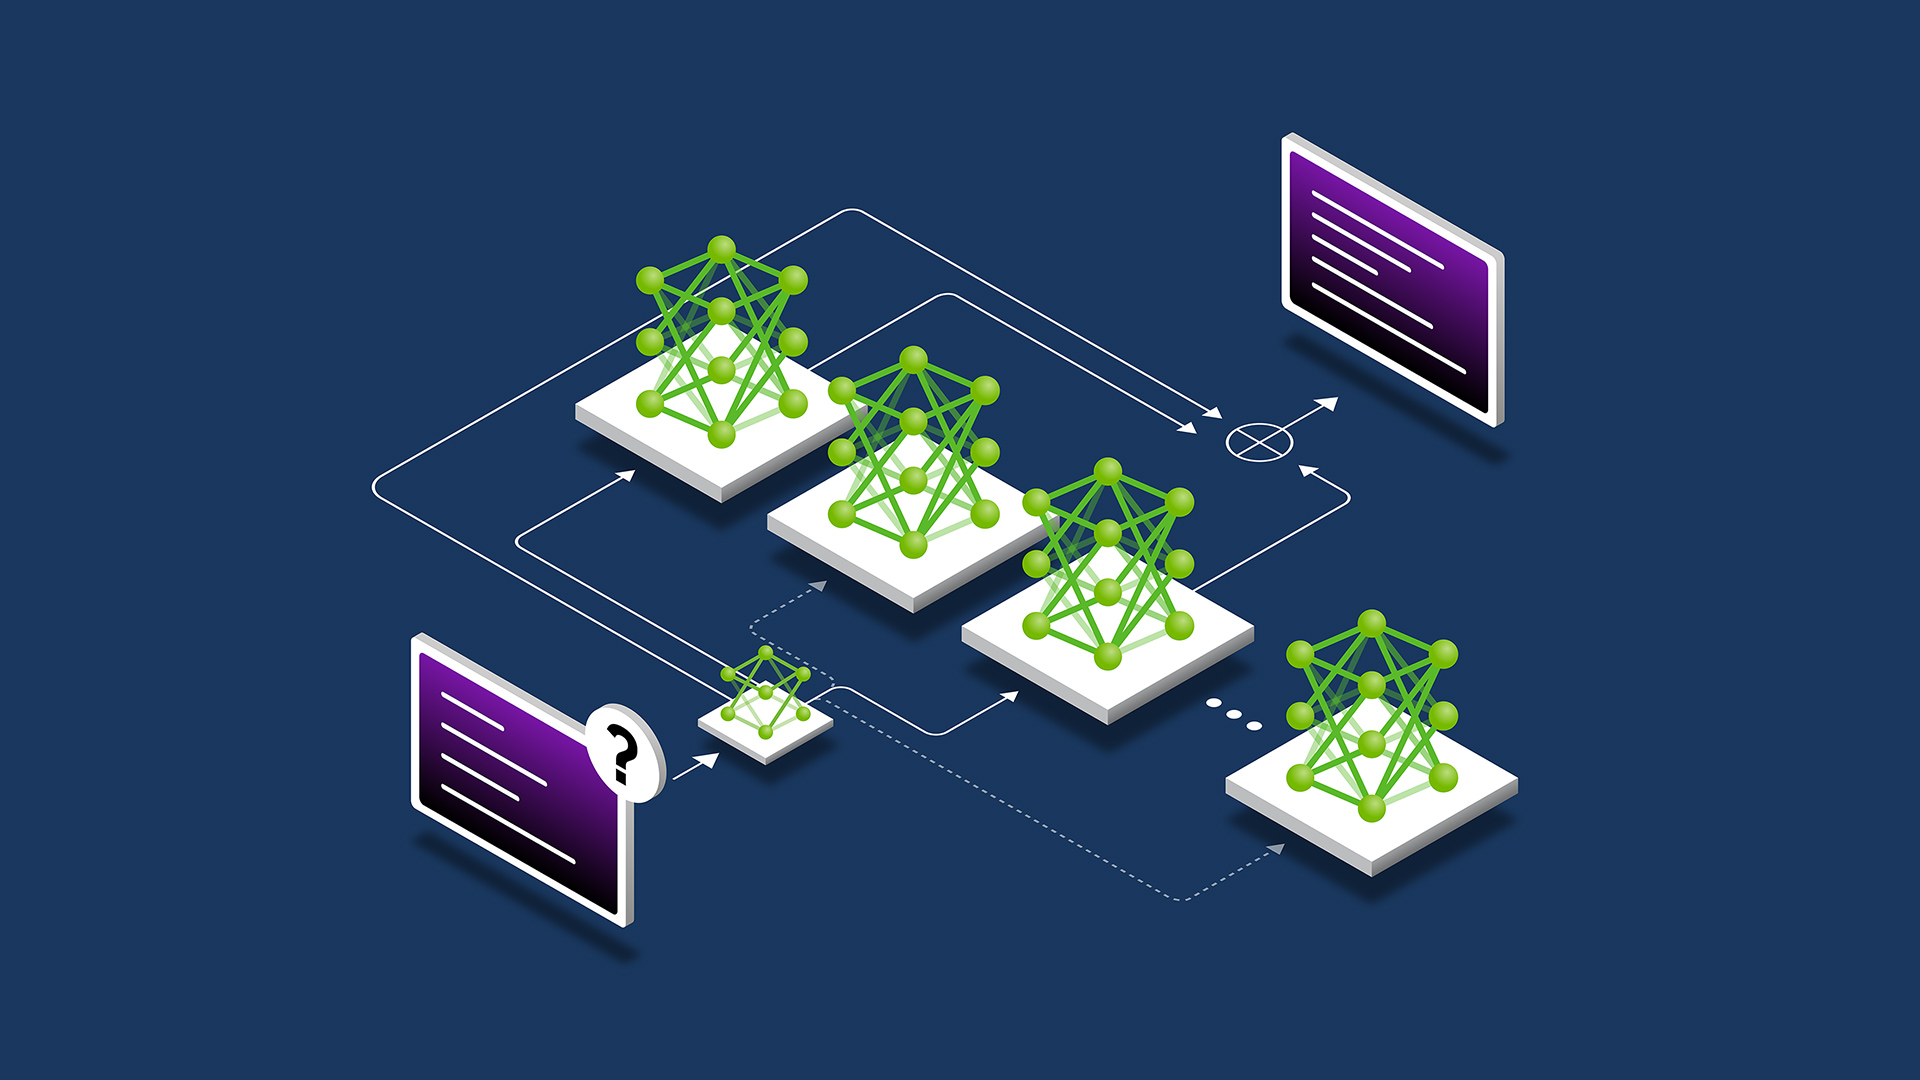
Los modelos de Inteligencia Artificial continúan creciendo en capacidad, pero aumentar su tamaño también puede incrementar considerablemente los recursos necesarios para ejecutarlos.
Una arquitectura utilizada para abordar parte de este desafío es Mixture of Experts (MoE).
En este enfoque, el modelo contiene diferentes componentes especializados, conocidos como expertos.
En determinadas implementaciones, un mecanismo de selección decide qué expertos participan en el procesamiento de cada token.
Esto permite que no todos los parámetros del modelo tengan que utilizarse activamente en cada operación.
La arquitectura puede ofrecer ventajas relacionadas con capacidad y eficiencia computacional, dependiendo del diseño.
Sin embargo, también introduce desafíos.
Es necesario administrar cómo se distribuyen las tareas entre los expertos, evitar desequilibrios y controlar los costos de comunicación cuando el modelo se ejecuta en múltiples dispositivos.
Además, disponer de muchos parámetros totales no significa automáticamente que el modelo sea mejor en todas las tareas.
La calidad depende del entrenamiento, los datos y la arquitectura completa.
Mini guía práctica: al comparar modelos MoE con modelos densos, analiza no solamente la cantidad total de parámetros, sino también los parámetros activos, la memoria requerida y el rendimiento real.
Tip Winxgo: las arquitecturas MoE muestran que aumentar la capacidad de un modelo no siempre implica utilizar todos sus componentes en cada operación.
¿Crees que los modelos Mixture of Experts terminarán predominando sobre las arquitecturas densas tradicionales?



Leave a Reply