

En una aplicación con muchos usuarios, las consultas a una base de datos pueden competir con las operaciones que modifican información. Cuando la carga de lectura es elevada, una estrategia posible es utilizar réplicas de lectura.
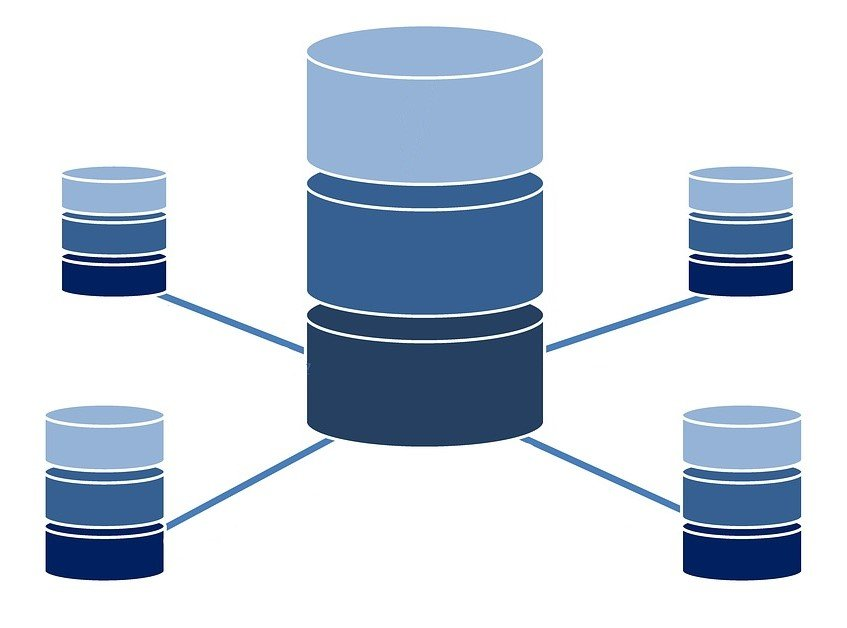
Una réplica de lectura es una copia de la base de datos que recibe cambios desde una instancia principal y puede atender consultas que no necesitan ejecutarse en el servidor primario.
Por ejemplo, una plataforma de comercio electrónico puede recibir muchas solicitudes para consultar catálogos, historiales o reportes. Algunas de esas consultas pueden dirigirse a réplicas, mientras que las operaciones de escritura siguen realizándose en la base principal.
Esto puede distribuir la carga y facilitar el escalamiento de determinados patrones de uso. También puede ayudar a separar las consultas analíticas de las transacciones habituales, dependiendo de la arquitectura.
Pero las réplicas suelen presentar un posible retraso respecto a la instancia principal. Si una persona actualiza un dato y consulta inmediatamente una réplica, podría no ver todavía el cambio.
Por eso es importante identificar qué consultas toleran una pequeña demora y cuáles necesitan leer siempre los datos más recientes.
Mini guía práctica: mide la proporción de lecturas y escrituras, identifica consultas que pueden dirigirse a réplicas y establece una estrategia para manejar el retraso de replicación.
Tip Winxgo: las réplicas de lectura pueden mejorar la capacidad de una base de datos, pero no deben utilizarse sin considerar la consistencia que necesita cada operación.
¿Preferirías una aplicación más rápida con un pequeño retraso en ciertos datos o una consulta siempre actualizada aunque tarde un poco más?



Leave a Reply