

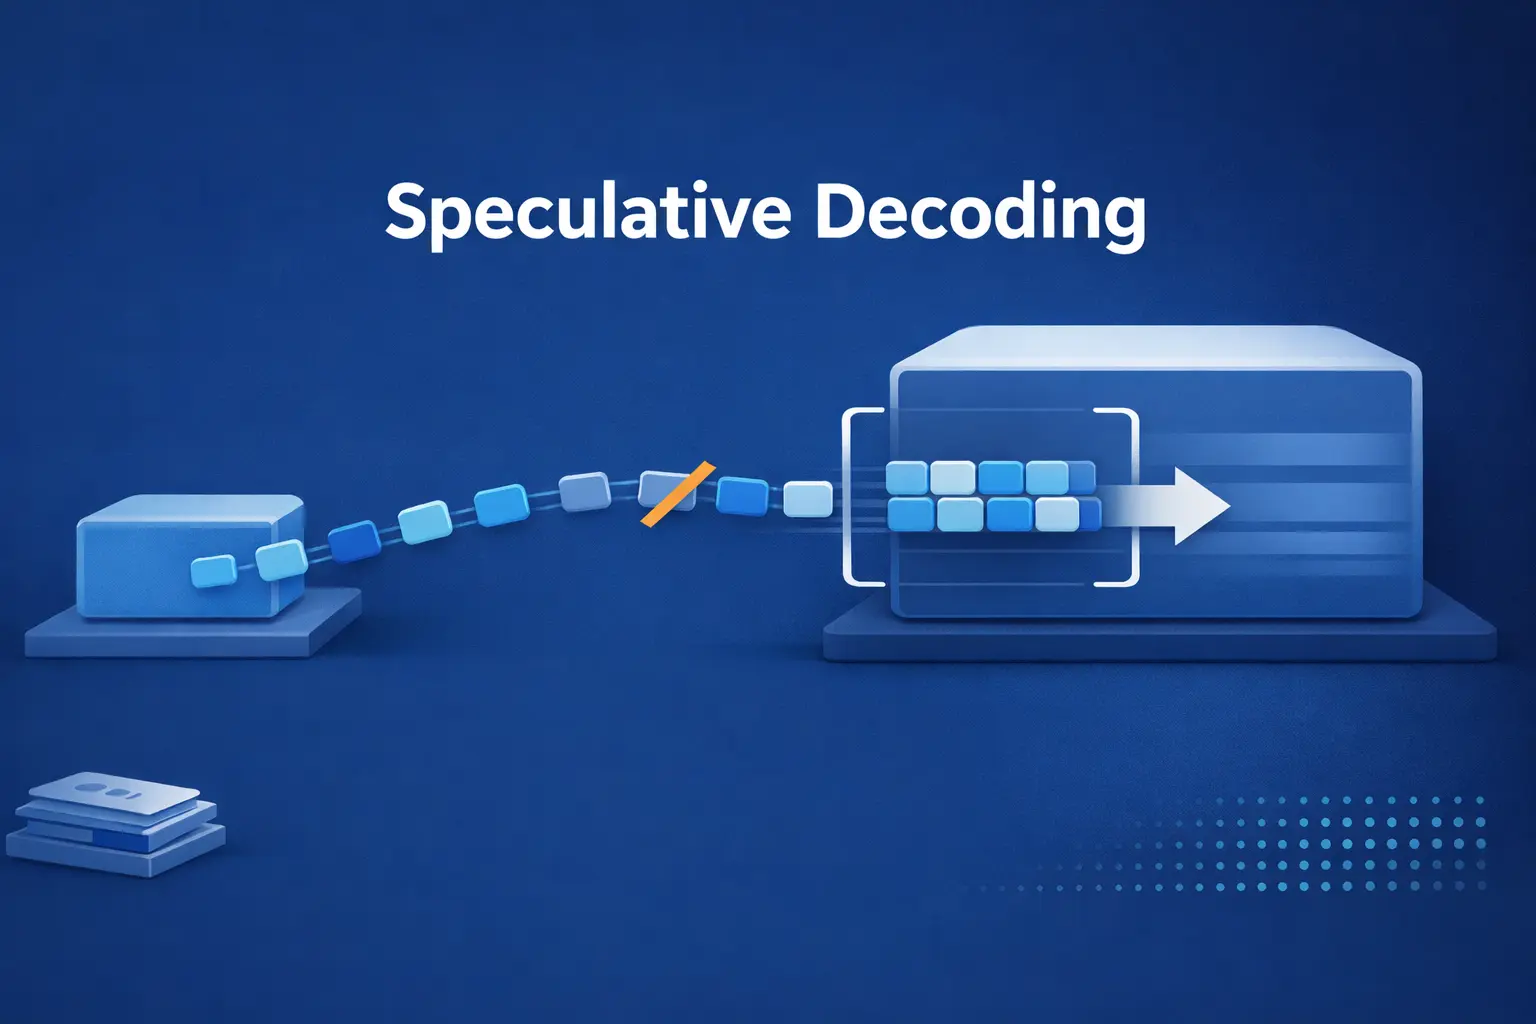
La generación de texto mediante modelos de lenguaje puede resultar costosa porque las respuestas se producen mediante procesos secuenciales de predicción.
Una técnica utilizada para acelerar determinadas implementaciones es Speculative Decoding.
Su funcionamiento general consiste en utilizar un modelo auxiliar o mecanismo de propuesta para anticipar varios tokens que posteriormente son verificados por el modelo principal.
Cuando las propuestas cumplen los criterios de aceptación, el sistema puede avanzar más rápidamente que si generara cada token utilizando exclusivamente el proceso convencional.
Esto puede reducir la latencia en determinadas condiciones.
Una característica interesante es que ciertos métodos de speculative decoding están diseñados para conservar la distribución de salida del modelo principal, siempre que se implementen correctamente.
Sin embargo, la aceleración depende de factores como la calidad de las propuestas, el hardware y las características del modelo.
Si el modelo auxiliar propone constantemente tokens que son rechazados, el beneficio puede disminuir.
También existe un costo adicional asociado con ejecutar los mecanismos de propuesta.
Mini guía práctica: evalúa la latencia real, la tasa de aceptación y el consumo de recursos antes de incorporar speculative decoding en una plataforma de inferencia.
Tip Winxgo: acelerar la IA no siempre requiere utilizar un modelo más pequeño. También es posible optimizar la manera en que se generan las respuestas.
¿Crees que las técnicas de aceleración de inferencia serán tan importantes como el desarrollo de modelos cada vez más grandes?



Leave a Reply